業務想把客戶訪談交給 AI 摘要,財務想上傳報表找異常,同事則用個人帳號請 AI 整理內部文件。這些動作看起來相似,風險卻完全不同。
不少企業最先問的是:「廠商會不會拿我們的資料訓練模型?」這當然重要。微軟表示,Microsoft 365 Copilot 的提示、回覆與透過 Microsoft Graph 取得的資料,不會用來訓練基礎大型語言模型;OpenAI 也表示,ChatGPT Enterprise、Business 與 API 的輸入及輸出,預設不會用來訓練或改善模型。
但「不拿資料訓練」不等於資料完全不會被處理或保存,也不能解決帳號用錯、權限過大及員工誤傳等問題。對企業來說,真正需要管理的不是單一模型,而是工具、資料、權限與紀錄。
1. 先確認工具與帳號,不要只看產品名稱
同一個 AI 服務的免費版、個人版、企業版與 API,可能適用不同的資料政策與管理機制。員工即使使用熟悉的產品,也可能登入個人帳號,而不是受到公司合約與管理設定保護的企業環境。
比較好的做法,是先提供公司核准的工具清單,並確認員工使用公司帳號。採購時除了詢問資料是否用於訓練,也要確認保存期限、刪除方式、資料處理地區、第三方服務,以及管理者能否停權與查閱稽核紀錄。
企業要確認的是「目前這個帳號與版本受到什麼保護」,而不是籠統地認為某個品牌一定安全。
2. 資料先分級,再決定能不能使用 AI
只告訴員工「不要上傳機密」通常不夠,因為大家對機密的理解並不一致。未公開報價、內部簡報或拿掉姓名的客戶資料,到底能不能使用,應由公司先定義。
可以從簡單的紅、黃、綠燈開始:
| 等級 | 常見內容 | 建議做法 |
|---|---|---|
| 綠燈 | 官網內容、公開新聞稿、公開法規 | 可使用公司核准的 AI,輸出仍須查核 |
| 黃燈 | 內部流程、會議摘要、一般營運資料 | 只使用必要片段,並遮蔽身分與敏感欄位 |
| 紅燈 | 個資、薪資、未公開財報、客戶合約、密碼與金鑰 | 原則上禁止輸入;有明確需求時改走核准流程或受控環境 |
去識別化只能降低風險,不是通行證。即使拿掉姓名,職稱、公司、日期與專案內容的組合,仍可能讓當事人被重新辨識。
更穩健的原則是資料最小化:只提供完成任務所需的內容,不要把整份檔案交給 AI。
台灣行政院的生成式 AI 參考指引也建議,不得向公開生成式 AI 提供應保密、個人或未經同意公開的資訊,並強調輸出仍須由承辦人做最終判斷。
3. AI 會沿用原有權限,也會放大過度分享的問題
企業版 AI 可以搜尋 Email、雲端檔案與會議紀錄,但通常仍依照使用者原有權限取得資料。以 Microsoft 365 Copilot 為例,系統只會呈現使用者至少具有檢視權限的內容。
這項設計不會憑空打開沒有權限的檔案,卻可能放大既有問題。如果 SharePoint 資料夾多年來都是「全公司可讀」,AI 會讓原本難以尋找的敏感內容變得容易被發現。
因此,導入 Copilot 前應先清查共用連結、群組權限、離職帳號及敏感文件,AI 不一定創造了資料外洩的缺口,但它會降低搜尋成本,讓舊有權限問題更快浮上檯面。
4. 保留使用紀錄,才能在出事時快速止血
當員工誤傳客戶名單或 AI 產生不當內容時,企業至少要能回答:誰在什麼時間使用哪個工具?輸入了哪些資料?資料是否送往第三方?能否刪除?哪些人或系統可能受到影響?如果所有人都使用個人帳號,又沒有集中管理、保存政策與離職停權機制,這些問題往往無法追查。
比較好的做法,是讓重要任務留下使用者、資料來源、輸出與核准紀錄,並事先定義通報窗口、停權方式及資料刪除流程。如此一來,稽核不只是為了究責,也能幫助企業在事件發生時縮小影響範圍。
安全使用 AI,重點是讓員工知道該走哪一條路
全面禁止 AI,可能讓需求轉向公司看不見的個人帳號;毫無限制地開放,又會放大原有的資料與權限問題。企業比較需要的,是提供可用的核准工具,搭配簡單清楚的資料分級與處理流程。
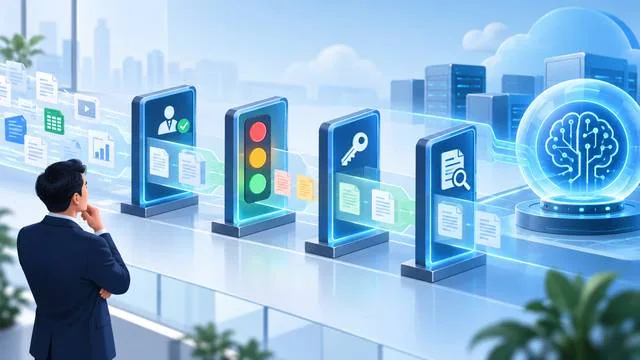
把資料交給 AI 前,可以先像過馬路一樣:確認工具、看清燈號、檢查權限,再留下可追蹤的紀錄。
真正的安全,不是相信某個模型永遠不會出錯,而是讓每一次資料使用都有清楚的邊界。